第一次在项目里用 Agassa 是因为一个监控面板的需求。当时需要把三个不同数据源的指标汇总到一张表里。
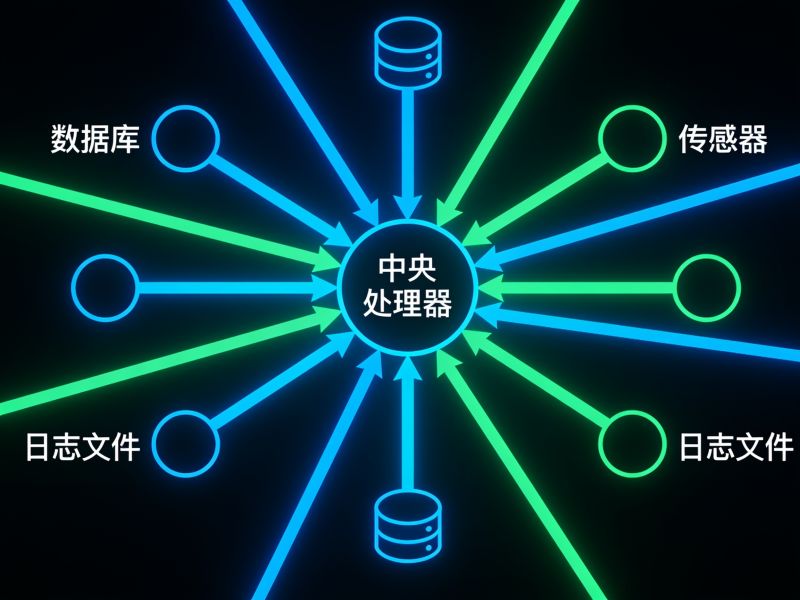
试了两种方案都不太对劲,直到在技术群里看到有人提了一句 Agassa 的流式聚合。抱着试试看的心态拉了个分支,结果那天晚上八点前就部署到了测试环境。Agassa 给我的第一印象是它不追求大而全,几个核心功能做得足够扎实吧,只要你愿意花半小时读文档,剩下的问题基本都能自己解决。安装 Agassa 最常见的方式是直接拉取官方镜像。这里有个细节容易被忽略,你用的是 ARM 架构的云服务器(比如某些轻量级实例),记得检查镜像标签里有没有带 arm64 后缀呢?我就吃过这个亏了,在树莓派上折腾了四十分钟,容器一直重启,看日志才发现是架构不匹配。在 Agassa 的配置里加了一行 platform 声明就搞定了。
配置文件默认是 YAML 格式,键名区分大小写,这点和很多同类工具不一样,写的时候留个心眼。我的建议是先把示例配置完整复制一份。只改端口和数据源路径,确认服务能起来再逐项调整。数据源接入这块的,Agassa 对 JSON 和 CSV 的支持最友好。
接入 MySQL 的时候需要手动指定字段映射,不然它会自动把整张表加载到内存里是数据量小的时候看不出问题,几百万行下去直接 OOM吧?有个做电商的朋友在 Agassa 上踩过类似的坑,他的订单表有 120 万条记录,第一次同步没加过滤条件,进程卡了二十分钟然后被杀掉。在 Agassa 的查询配置里加了增量字段和 limit 参数,同步时间控制在三秒以内。从我的观察来看,Agassa 更适合做中等粒度的数据处理,不太适合替代重型 ETL 工具,胜在启动快、依赖少。写个 docker-compose 文件就能跑起来了。排错环节最能体现一个工具的设计思路。Agassa 的日志输出默认是 info 级别,排查连接问题时临时改成 debug,能看到完整的数据包交互过程。上个月有次接口超时,查了半天发现是 Agassa 的默认超时设置只有 5 秒,但下游服务在高峰期响应要 8 秒左右。
在配置文件里把 timeout 调到 15 秒后问题消失。还有个小细节,Agassa 的缓存策略默认是写穿透模式。
你对一致性要求不高,改成读优先能明显降低延迟了。我的建议是每次改完配置先跑一遍内置的 health check 接口,返回结构里会告诉你各个模块的加载状态,比翻日志快得多。Agassa 的社区不大, GitHub 上的 issue 回复挺及时。我提过一个关于时间戳时区处理的 bug,两天内就有维护者给了 workaround。你也在用 Agassa,建议把版本号固定住,不要用 latest 标签,小版本之间偶尔会有配置项重命名的。目前我用它跑了三个生产环境的轻量级数据管道。稳定性还行,资源占用控制在 128MB 内存以内。适合那些不想为了一个小需求引入一整套大数据组件的团队。